
Megascan超大规模规则匹配库
Megascan是鲲鹏BoostKit高性能超大规模规则匹配库,可有效处理千万数量级的规则匹配。
规则匹配是智能数据分析场景的核心需求,而超大规模规则匹配是常见痛点,以Ultrascan为代表的规则匹配库在面对十万以上数量的规则集时性能会急剧衰减,需要定制对超大规模规则匹配的专用算法库。
Megascan针对两类场景定制了不同的算法:对十万数量级不定长规则集使用基于AC(Aho-Corasick)前缀树的浮动多模式匹配算法;对千万数量级定长规则集使用基于Hash的固定多模式匹配算法。

Megascan的工作流程分两阶段:规则预处理阶段和规则匹配阶段。

面对超大规模规则集时,Megascan使用二级hash结构维护规则,在保证增删改效率不劣化的情况下提升搜索速度。

Megascan对外提供两套接口——一套是遗留的 handler 兼容接口( ms_handler / ms_rule / ms_compile / ms_runtime ),另一套是 database + scratch + stream 三层对象模型接口;功能上不仅支持普通规则,还支持由逻辑运算( & 、 | 、 ! )构成的组合规则,支持 Block 全量扫描、跨分片 Stream 扫描、运行时动态删除规则,以及分类型自定义内存分配器(database / scratch / stream / misc)。
- 逻辑组合
组合规则(如 101&102、!101)本身不做底层匹配,而是基于普通规则的匹配结果推导得出;编译期把每条组合表达式解析为逻辑表达式树,并为每个普通规则分配一个逻辑位(记录其是否命中),同时建立从”普通规则”到”依赖它的组合规则”的反向索引;运行期当某普通规则命中时,先置位其逻辑位,再借反向索引只求值本次命中所影响的少数组合规则(增量求值),而不是遍历全部组合规则,从而在大规模组合规则下大幅降低无效计算。

- 流模式
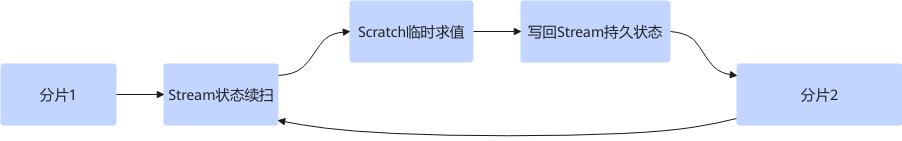
流模式把连续数据拆成多个分片依次扫描,核心是将”跨分片持久状态”与”单次扫描临时工作区”分离:Stream 保存 AC 自动机的状态结点、累计偏移和逻辑状态,使匹配能跨越任意分片边界;Scratch 则保存本次扫描的命中缓冲、求值结果等临时数据并对多个分片复用,同时仅记录本分片改动过的状态字节,使重置时只需清理这些脏字节,避免全量清除,从而在长流、多分片场景下保持高效。
- 规则老化
规则老化指运行时动态删除规则的能力:删除请求先在”候选”状态上完成全部变更——从紧凑 AC 结构中排除被删的普通规则,并从编译上下文移除对应组合规则及其依赖关系——验证成功后再一次性原子提交替换,并令版本号递增;由于每次变更都会增加版本号,删除前创建的流状态对象和临时工作区会在下次使用时感知版本变化,流状态对象需要重置,临时工作区则自动刷新。删除应在所有正在进行的扫描结束后执行,从而保证后续扫描使用一致的规则库状态。

关键技术:
AC前缀树数组化查表优化,AC自动机;多级Hash,Hash并行化,向量化冲突校验。
适用场景:
信息安全数据分流,运营商数据精细分流,安平数据分流,IDPS,WAF,大模型应用防火墙等。