单文件扫描模式使用场景(x86 Intel intrinsics分析)
用户可以通过在命令./tiancheng file之后,添加“--enable-intel-intrinsics”参数的方式,启用x86 Intel intrinsics分析功能,分析源码文件中的x86向量化指令,实现对x86向量化代码的改写。

火焰图扫描模式和函数扫描模式也支持启用x86 Intel intrinsics分析功能,此示例以文件扫描模式中扫描单个源码文件时启用x86 Intel intrinsics分析功能为例。
前提条件
以天秤源码优化工具安装路径“/home/tiancheng-x.x.x-Linux-Kunpeng”为例。
x86 Intel intrinsics单文件扫描分析
./tiancheng file --enable-intel-intrinsics -i /home/demo/input.cpp -o /home/demo
- 执行上述命令会启用x86 Intel intrinsics分析功能,对“/home/demo”下的input.cpp源码文件进行扫描,分析input.cpp源码文件中的x86向量化指令,在“/home/demo”路径下生成HTML向量化检查报告和JSON报告文件。
- 当启用x86 Intel intrinsics分析功能时HTML向量化检查报告中才有函数向量化检查报告,不启用时报告中只有循环向量化检查报告和任务信息。
返回信息如下:
Compile database file does not exist or is unreachable.
Analyzing file: /home/demo/input.cpp // 提示开始分析input.cpp源文件

>>> X86 detected. Configuring Virtual Environment...

compile_commands.json not found under: /home/demo
Recursively collecting include paths as fallback.

[Scan] Target  : /home/demo/input.cpp
[Scan] Mode    : direct scan (source file)
[Scan] Entry   : /home/demo/input.cpp

Start to scan code.// 提示开始扫描代码。

Vectorization check task is being executed. Please wait...
Scanning start time: 2026/08/11 15:32:26
For the details information, please check:
Successfully generated vectorization report: /home/demo/Vectorization_Source_20260814_190207_001_6209.html // 提示HTML向量化检查报告文件的存放路径。
Successfully generated vectorization optimization result: /home/demo/Vectorization_Optimization_Result_20260814_190207_001_6209.json // 提示JSON报告文件的存放路径。
输出目录中包含两类分析报告,请根据实际需求选择查看:
- JSON报告文件:仅包含已成功优化的可向量化代码片段,适用于快速提取优化结果场景。
- HTML报告文件:提供全景视图,详细展示“可向量化”、“潜在向量化”及“不可向量化”三类代码,适用于深入分析优化潜力场景。
查看向量化检查结果
- 查看HTML向量化检查报告文件。报告内容包括循环向量化检查报告、函数向量化检查报告和任务信息。
单击“循环向量化检查报告”查看循环检查结果。具体内容如下图所示,报告结果参数说明请参见表2。
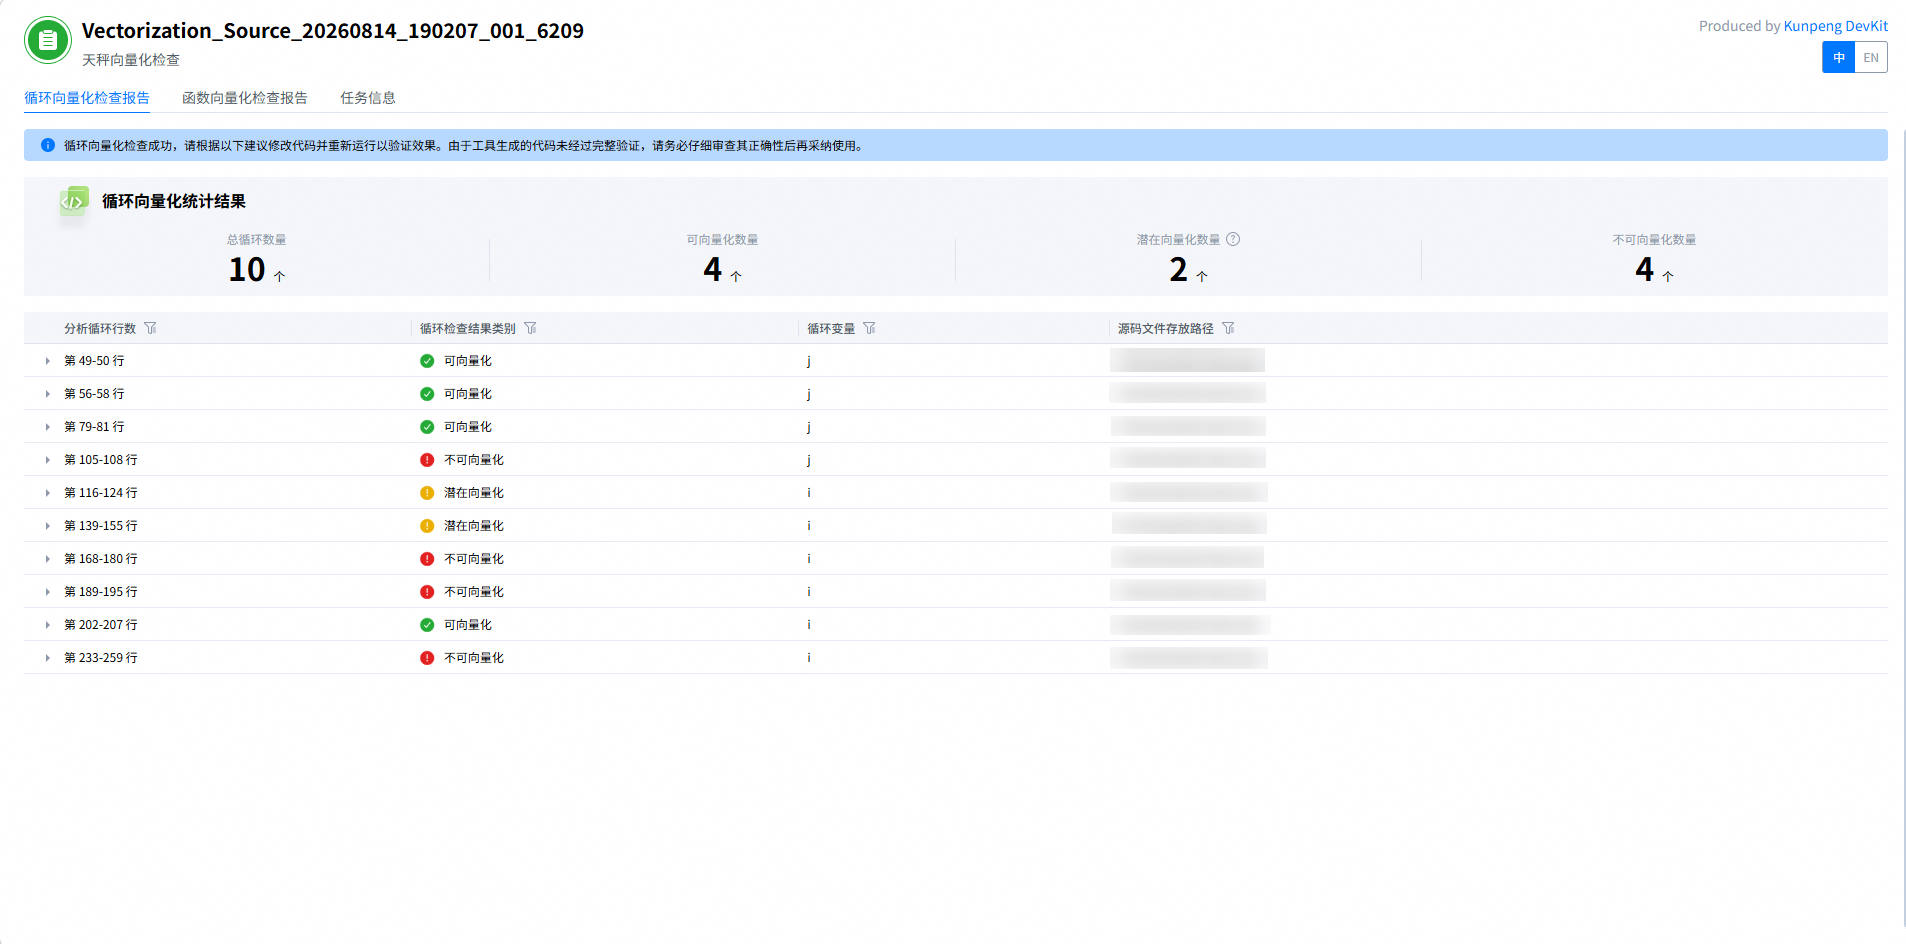
表1 报告结果参数说明 参数
说明
循环向量化统计结果
总循环数量
源码文件中扫描出的循环总数。
可向量化数量
源码文件中扫描出的可以进行向量化的循环数量。
潜在向量化数量
需要进行特殊处理(如函数内联)才有可能向量化的循环数量。
不可向量化数量
源码文件中扫描出的不可向量化的循环数量。
分析循环行数
被识别为待优化循环的源码在源码文件中的具体行号位置。
循环检查结果类别
天秤源码优化工具检查出的循环类别,包括可向量化、潜在向量化和不可向量化三种类别。
循环变量
在循环中进行循环的变量。
源码文件存放路径
循环所在源码文件的存放路径。
在循环检查结果类别中可以筛选出不同类别的循环,默认全选,单击筛选出的任一行可以展开具体的循环分析过程。
单击“分析循环行数”展开循环分析过程,包括可向量化、潜在向量化、不可向量化三种循环分析过程。循环分析过程参数说明请参见表2。
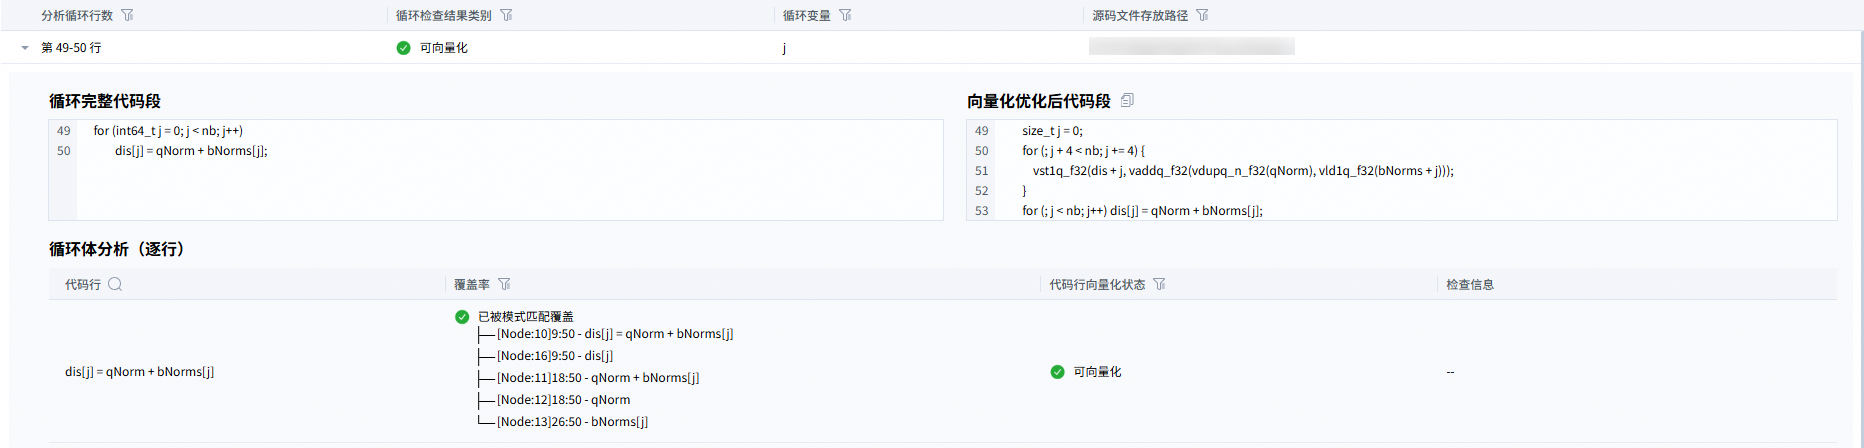
- 可向量化循环分析过程如下图所示。如示例中所示,将向量化优化后的代码段复制并替换源文件对应位置(第49-50行)的代码,保存修改后的文件即可完成改写。
天秤源码优化工具对支持改写的模块,直接提供优化后的代码段;对暂未匹配的模块,将在循环体逐行分析中输出向量化检查信息,可根据向量化检查结果进行优化。
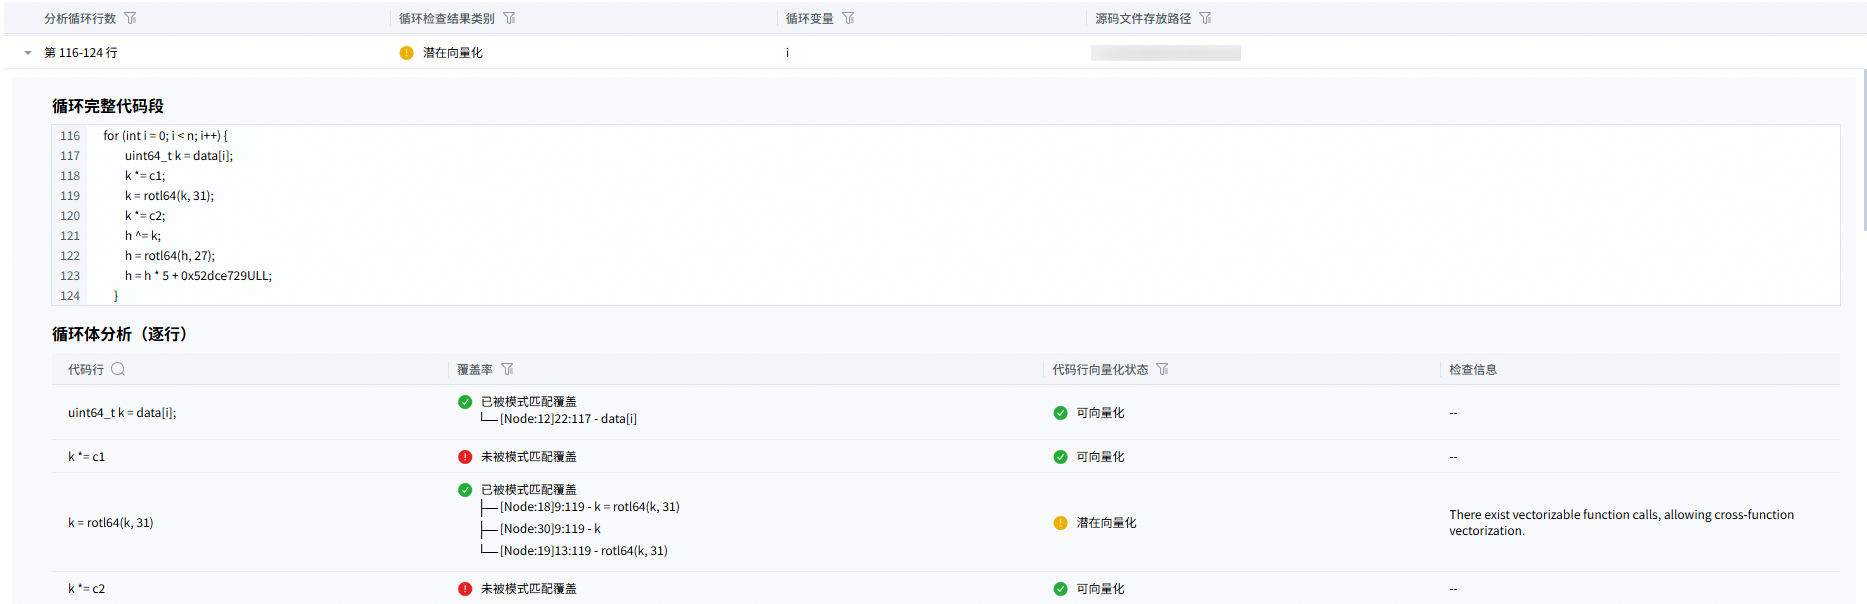
- 潜在向量化循环分析过程如下图所示。根据检查信息可查看源文件对应位置(第116-124行)代码的潜在向量化原因。
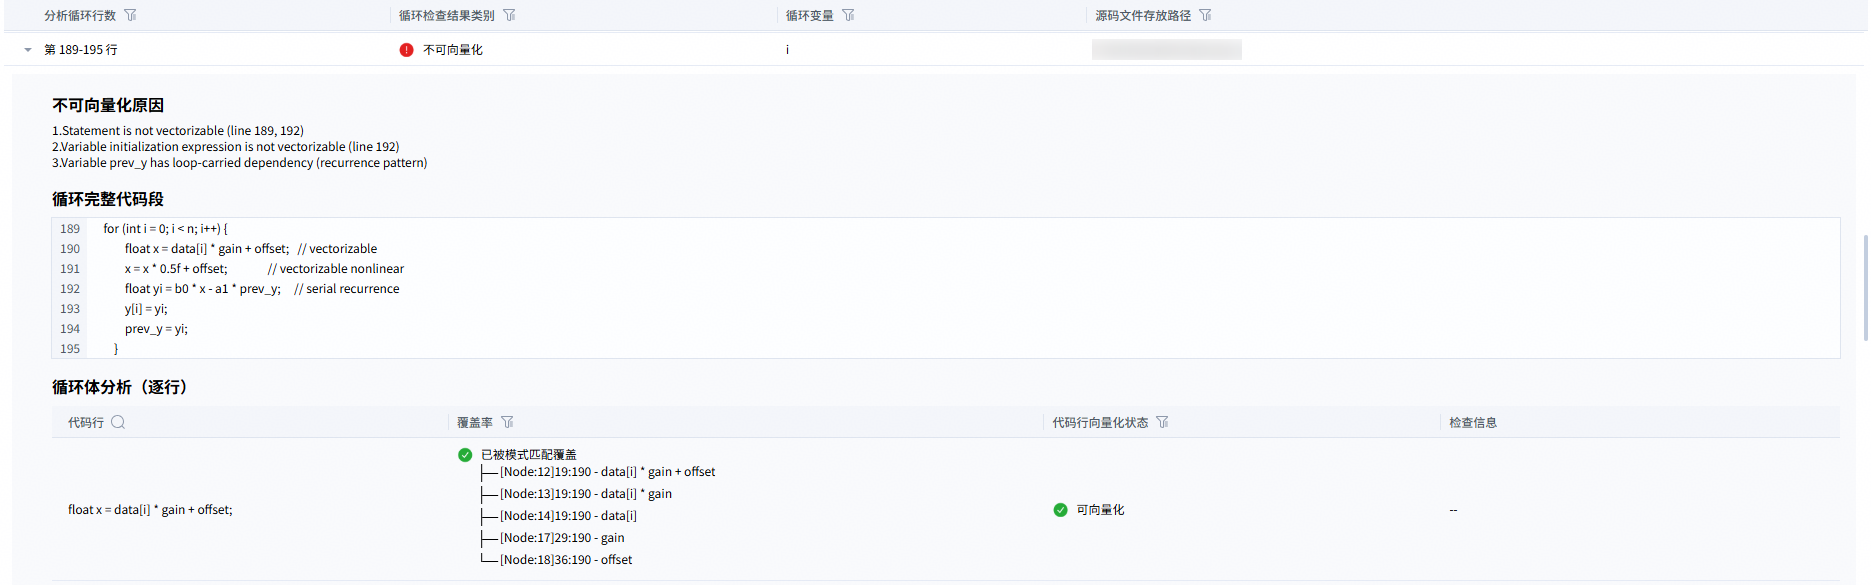
- 不可向量化循环分析过程如下图所示。根据检查信息可查看源文件对应位置(第189-195行)代码的不可向量化原因。
表2 循环分析过程参数说明 循环分析过程
参数
说明
可向量化分析
循环完整代码段
循环在源码文件中的代码段。
向量优化后代码段
天秤源码优化工具对循环进行向量化优化后的代码段。
潜在向量化分析
循环完整代码段
循环在源码文件中的代码段。
不可向量化分析
不可向量化原因
天秤源码优化工具将循环判断为不可向量化的原因。
循环完整代码段
循环在源码文件中的代码段。
公有参数
循环体分析(逐行)
天秤源码优化工具对循环进行检查分析的过程。
代码行
循环中循环体的代码行。
覆盖率
是否被天秤可向量化模式匹配覆盖。
代码行向量化状态
循环体单个代码行的向量化状态,包括可向量化、潜在向量化、不可向量化三种类别。
检查信息
天秤源码优化工具对代码行的检查分析结果。
说明:如果代码行向量化状态为可向量化,则不显示检查信息,如果代码行向量化状态为潜在向量化和不可向量化,则显示对应的原因或建议。
单击“函数向量化检查报告”查看函数检查结果。具体内容如下图所示,报告结果参数说明请参见表3。
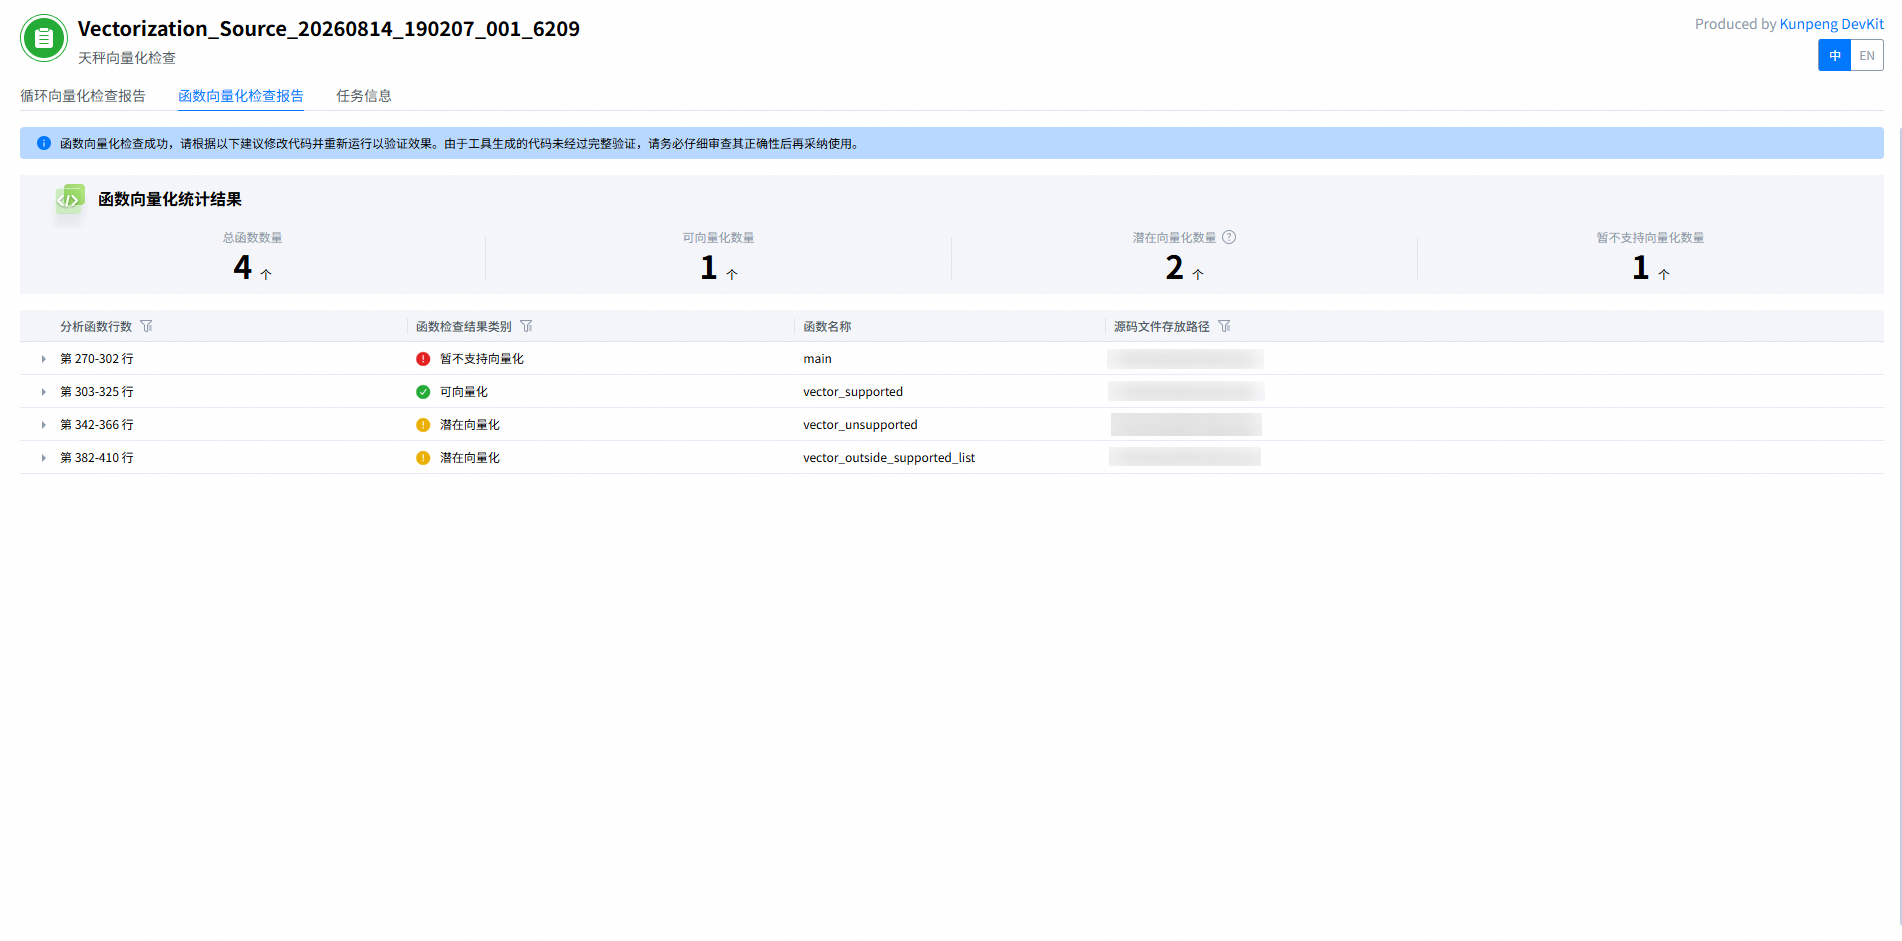
表3 报告结果参数说明 参数
说明
函数向量化统计结果
总函数数量
源码文件中扫描出的函数总数。
可向量化数量
源码文件中扫描出的可以进行向量化的函数数量。
潜在向量化数量
存在可改写指令但是天秤源码优化工具暂不支持改写的函数数量。
暂不支持向量化数量
源码文件中扫描出的暂不支持向量化的函数数量。
分析函数行数
函数在源码文件中的代码行数。
函数检查结果类别
天秤源码优化工具检查出的函数类别,包括可向量化、潜在向量化和暂不支持向量化三种类别。
函数名称
天秤源码优化工具进行向量化检查的函数名。
源码文件存放路径
函数所在源码文件的存放路径。
在函数检查结果类别中可以筛选出不同类别的函数,默认全选,单击筛选出的任一行可以展开具体的函数分析过程。
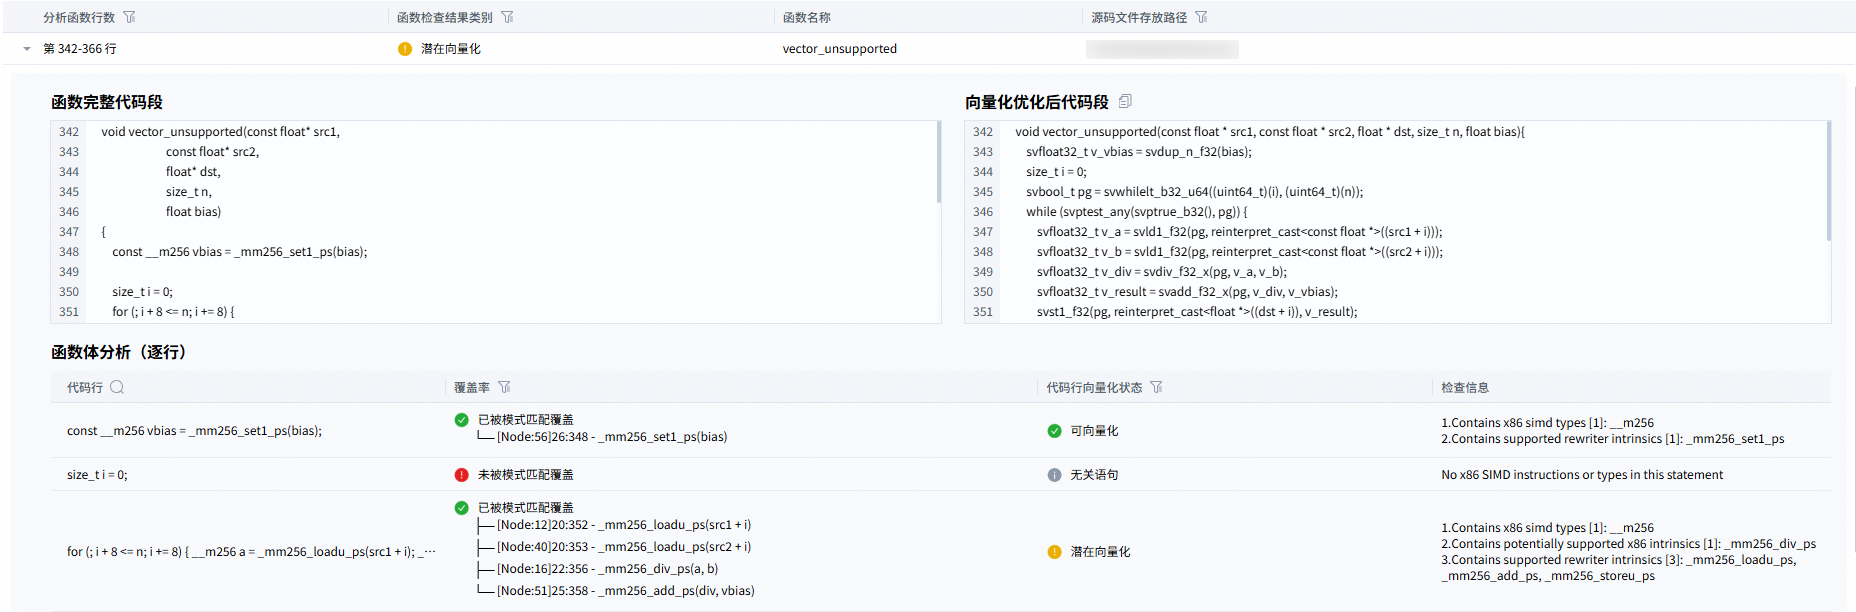
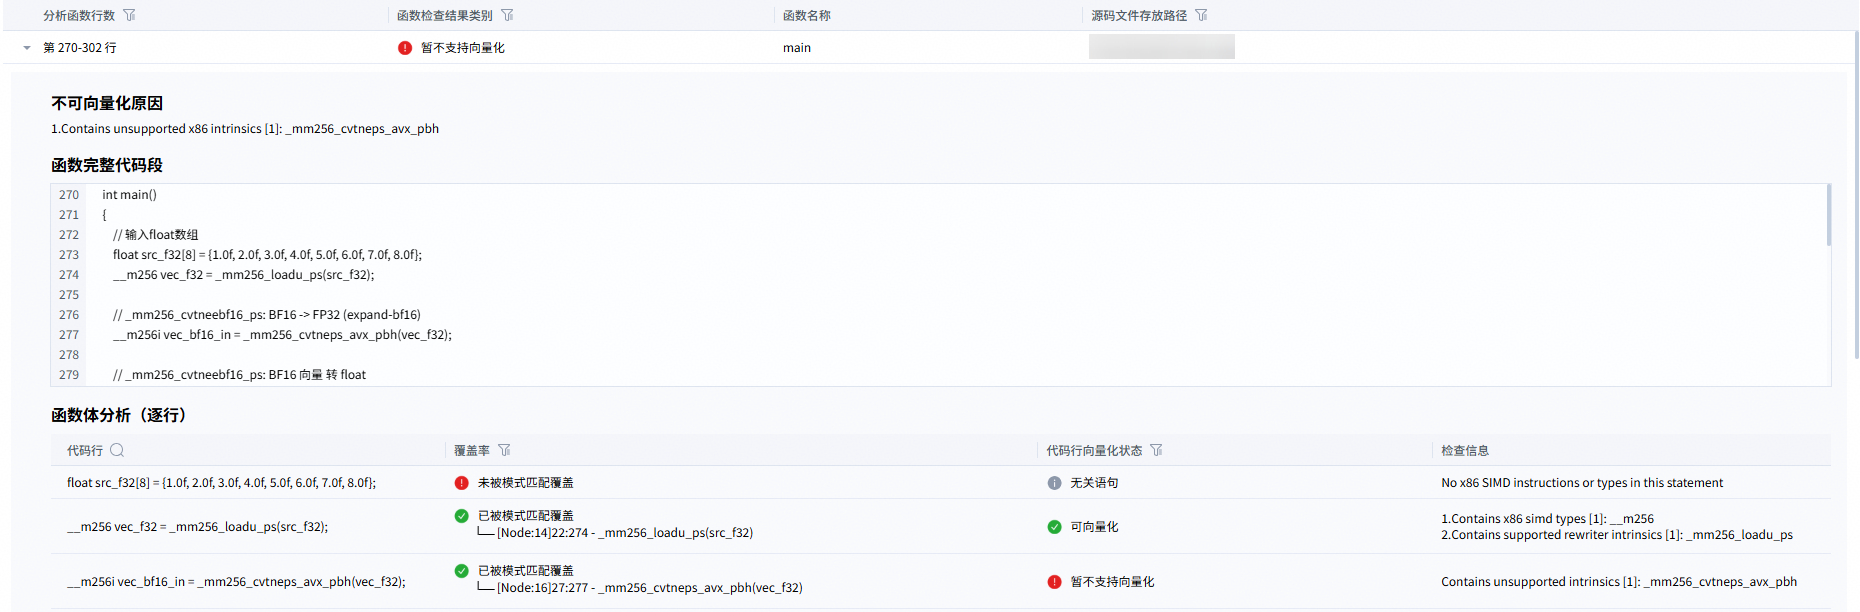
单击“分析函数行数”展开函数分析过程,包括可向量化、潜在向量化和暂不支持向量化三种函数分析过程。函数分析过程参数说明请参见表4。
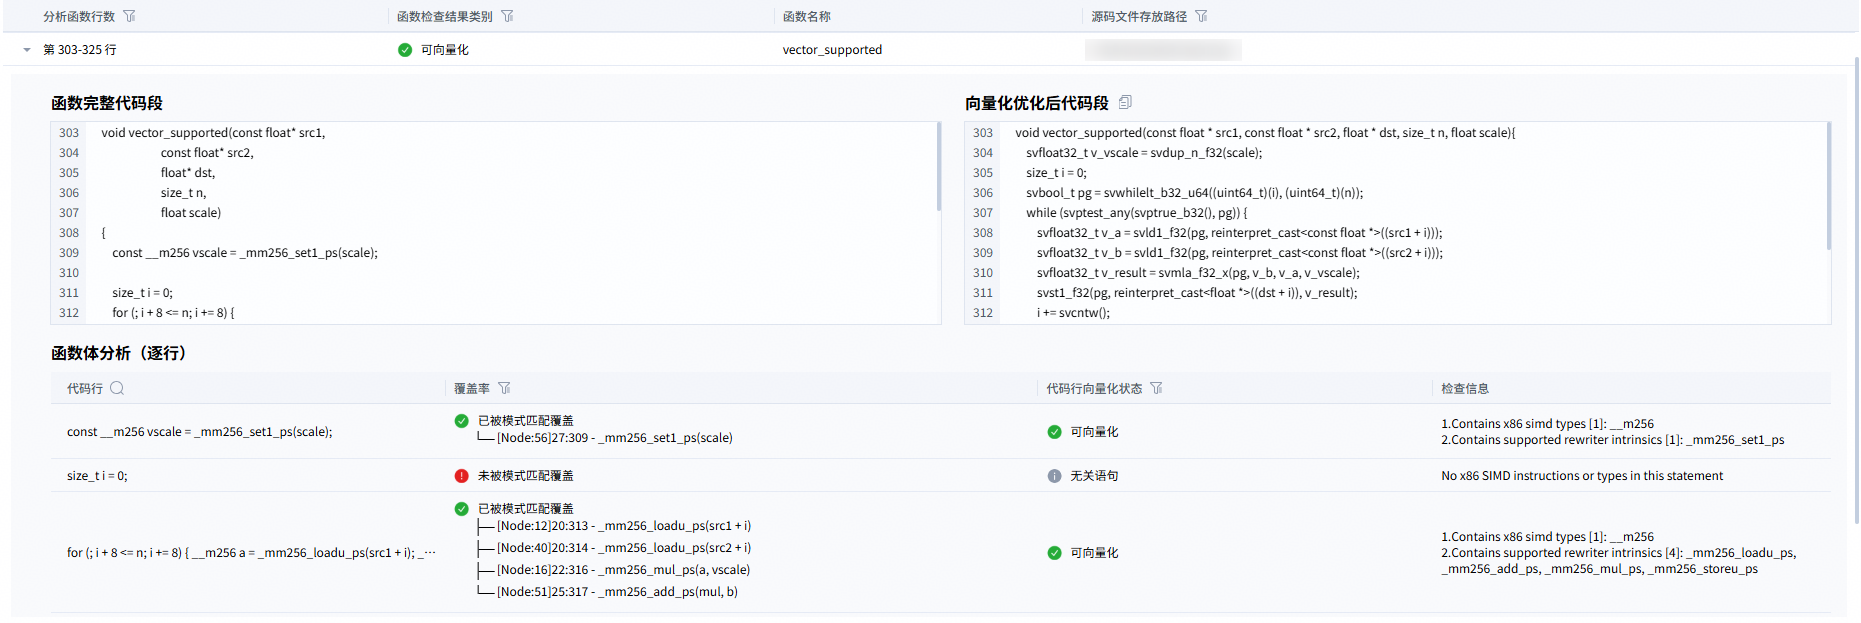
- 可向量化函数分析过程如下图所示。如示例中所示,将向量化优化后的代码段复制并替换源文件对应位置(第303-325行)的代码,保存修改后的文件即可完成改写。
- 潜在向量化函数分析过程如下图所示。根据检查信息可查看源文件对应位置(第342-366行)代码的潜在向量化原因。
- 暂不支持向量化函数分析过程如下图所示。根据检查信息可查看源文件对应位置(第270-302行)代码的暂不支持向量化原因。
表4 函数分析过程参数说明 函数分析过程
参数
说明
可向量化分析
函数完整代码段
函数在源码文件中的代码段。
向量优化后代码段
天秤源码优化工具对函数进行向量化优化后的代码段。
潜在向量化分析
函数完整代码段
函数在源码文件中的代码段。
暂不支持向量化分析
不可向量化原因
天秤源码优化工具的改写模块暂未适配,暂不支持向量化改写。
函数完整代码段
函数在源码文件中的代码段。
向量优化后代码段
天秤源码优化工具对函数进行向量化优化后的代码段。
公有参数
函数体分析(逐行)
天秤源码优化工具对函数进行检查分析的过程。
代码行
函数中函数体的代码行。
覆盖率
是否被天秤可向量化模式匹配覆盖。
代码行向量化状态
函数体单个代码行的向量化状态,包括可向量化、潜在向量化、暂不支持向量化、仅含有x86类型变量和无关语句五种类别。
检查信息
天秤源码优化工具对代码行的检查分析结果。
说明:如果代码行向量化状态为可向量化,则不显示检查信息,如果代码行向量化状态为潜在向量化和不可向量化,则显示对应的原因或建议。
单击“任务信息”可查看当前检查报告的生成信息,具体内容如下图所示。任务信息参数说明请参见表5。
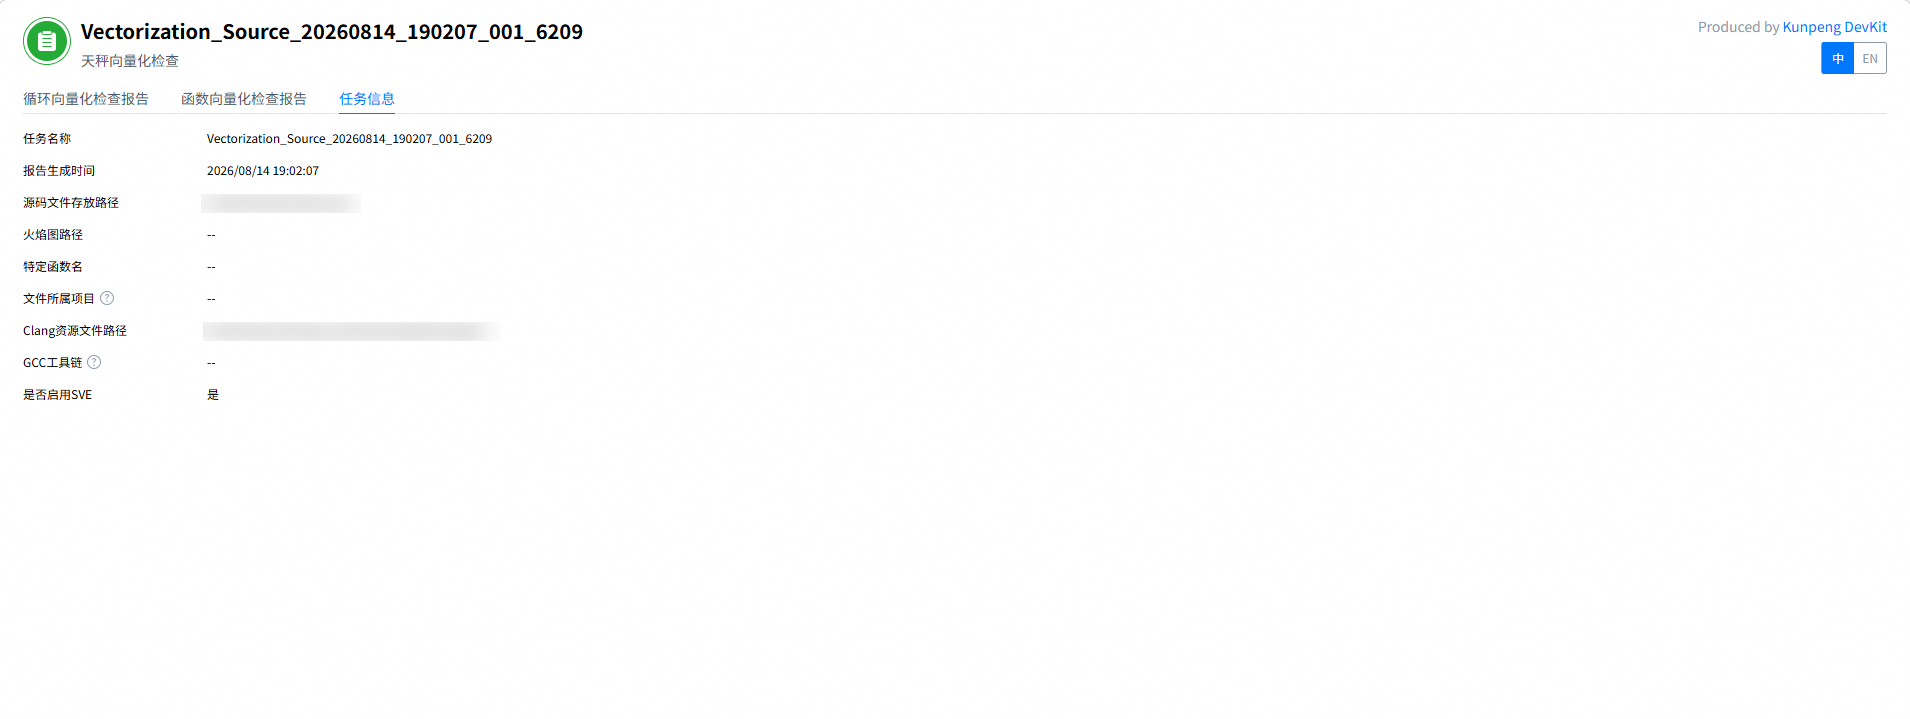
在“任务信息”中可快速查看报告名称、报告生成时间、源码存放路径等相关信息。
表5 任务信息参数说明 参数
说明
任务名称
天秤源码优化工具自动创建的检查任务名。
报告生成时间
天秤源码优化工具生成报告的时间。
源码文件存放路径
扫描的源码所在文件的路径。
火焰图路径
扫描的火焰图SVG文件的路径。
特定函数名
扫描的函数名。
文件所属项目
待分析源码文件所属项目的根目录。
Clang资源文件路径
Clang内置头文件(如stddef.h)所在的目录。
GCC工具链
GCC编译器安装的目录,作为代码分析时的工具链路径。
是否启用SVE
是否转换为SVE指令集。
HTML报告侧重诊断分析,需根据提示人工调整代码结构,调整后重新验证效果。
- 可向量化循环分析过程如下图所示。如示例中所示,将向量化优化后的代码段复制并替换源文件对应位置(第49-50行)的代码,保存修改后的文件即可完成改写。
- 查看JSON报告文件。
vim /home/demo/Vectorization_Optimization_Result_20260814_190207_001_6209.json
JSON文件详情如下:
{
  "advisor_items": [
    {
      "opt_file": {
        "begin_line": 303,
        "description": "",
        "end_line": 325,
        "fileName": "/home/demo/input.cpp",
        "headerFile": {
          "name": "#include <arm_sve.h>",
          "operation": ""
        },
        "headerLocBegin": -1,
        "headerLocEnd": -1,
        "sample_code": "void vector_supported(const float * src1, const float * src2, float * dst, size_t n, float scale){\n    svfloat32_t v_vscale = svdup_n_f32(scale);\n    size_t i = 0;\n    svbool_t pg = svwhilelt_b32_u64((uint64_t)(i), (uint64_t)(n));\n    while (svptest_any(svptrue_b32(), pg)) {\n        svfloat32_t v_a = svld1_f32(pg, reinterpret_cast<const float *>((src1 + i)));\n        svfloat32_t v_b = svld1_f32(pg, reinterpret_cast<const float *>((src2 + i)));\n        svfloat32_t v_result = svmla_f32_x(pg, v_b, v_a, v_vscale);\n        svst1_f32(pg, reinterpret_cast<float *>((dst + i)), v_result);\n        i += svcntw();\n        pg = svwhilelt_b32_u64((uint64_t)(i), (uint64_t)(n));\n    }\n    for (; i < n; ++i) {\n        dst[i] = src1[i] * scale + src2[i];\n    }\n}"
      }
    },
    {
      "opt_file": {
        "begin_line": 342,
        "description": "",
        "end_line": 366,
        "fileName": "/home/demo/input.cpp",
        "headerFile": {
          "name": "#include <arm_sve.h>",
          "operation": ""
        },
        "headerLocBegin": -1,
        "headerLocEnd": -1,
        "sample_code": "void vector_unsupported(const float * src1, const float * src2, float * dst, size_t n, float bias){\n    svfloat32_t v_vbias = svdup_n_f32(bias);\n    size_t i = 0;\n    svbool_t pg = svwhilelt_b32_u64((uint64_t)(i), (uint64_t)(n));\n    while (svptest_any(svptrue_b32(), pg)) {\n        svfloat32_t v_a = svld1_f32(pg, reinterpret_cast<const float *>((src1 + i)));\n        svfloat32_t v_b = svld1_f32(pg, reinterpret_cast<const float *>((src2 + i)));\n        svfloat32_t v_div = svdiv_f32_x(pg, v_a, v_b);\n        svfloat32_t v_result = svadd_f32_x(pg, v_div, v_vbias);\n        svst1_f32(pg, reinterpret_cast<float *>((dst + i)), v_result);\n        i += svcntw();\n        pg = svwhilelt_b32_u64((uint64_t)(i), (uint64_t)(n));\n    }\n    for (; i < n; ++i) {\n        dst[i] = src1[i] / src2[i] + bias;\n    }\n}"
      }
    },
    {
      "opt_file": {
        "begin_line": 382,
        "description": "",
        "end_line": 410,
        "fileName": "/home/demo/input.cpp",
        "headerFile": {
          "name": "#include <arm_sve.h>",
          "operation": ""
        },
        "headerLocBegin": -1,
        "headerLocEnd": -1,
"sample_code": "void vector_outside_supported_list(const float * src1, const float * src2, const int * indices, const int * permute_indices, float * dst){\n    svint32_t v_index_vec = svld1_s32(svptrue_pat_b32(SV_VL8), reinterpret_cast<const int32_t *>((indices)));\n    svint32_t v_perm = svld1_s32(svptrue_pat_b32(SV_VL8), reinterpret_cast<const int32_t *>((permute_indices)));\n}"
      }
    }
  ],
  "code": 0,
  "recognizedPattern": 3
}
表6 字段说明 字段
字段说明
advisor_items
代码优化点建议数组,里面的每一项都是一个代码优化点建议。
opt_file
单个优化建议的详细信息。
begin_line
需要优化代码的起始行号。
示例中“303”为优化代码的起始行号。
description
优化建议的详细描述。
end_line
需要优化代码的结束行号。
示例中“325”为优化代码的结束行号。
fileName
当前分析的源文件所在路径。
示例中“/home/demo/input.cpp”为分析的源文件所在路径。
headerFile
向量化过程中涉及的头文件处理信息。
示例中"name": "#include <arm_sve.h>"表明此段代码需要新增或替换的目标头文件,用于使用SVE指令集,"operation": ""表明该指定头文件的处理方式。
“operation”包含的两种处理方式:
- “add”:用于标量代码向量化时新增目标头文件。
- “replace”:用于x86向ARM向量化迁移时将原有x86头文件替换为对应的ARM头文件。
headerLocBegin
头文件插入的起始行号。
- 若为-1,表示头文件在原始代码中已经包含,无需手动添加。
- 若为正整数,表示头文件插入的起始行号。
示例中“-1”表示头文件在原始代码中已经包含,无需手动添加。
headerLocEnd
头文件插入的结束行号。
- 若为-1,表示头文件在原始代码中已经包含,无需手动添加。
- 若为正整数,表示头文件插入的结束行号。
示例中“-1”表示头文件在原始代码中已经包含,无需手动添加。
sample_code
推荐的向量化实现代码样例,可直接用于替换源文件的原始代码。
示例中以下代码为优化后的代码样例。
void vector_supported(const float * src1, const float * src2, float * dst, size_t n, float scale){\n svfloat32_t v_vscale = svdup_n_f32(scale);\n size_t i = 0;\n svbool_t pg = svwhilelt_b32_u64((uint64_t)(i), (uint64_t)(n));\n while (svptest_any(svptrue_b32(), pg)) {\n svfloat32_t v_a = svld1_f32(pg, reinterpret_cast<const float *>((src1 + i)));\n svfloat32_t v_b = svld1_f32(pg, reinterpret_cast<const float *>((src2 + i)));\n svfloat32_t v_result = svmla_f32_x(pg, v_b, v_a, v_vscale);\n svst1_f32(pg, reinterpret_cast<float *>((dst + i)), v_result);\n i += svcntw();\n pg = svwhilelt_b32_u64((uint64_t)(i), (uint64_t)(n));\n }\n for (; i < n; ++i) {\n dst[i] = src1[i] * scale + src2[i];\n }\n}code
工具执行状态码。
- 0表示工具执行成功。
- 非零值表示异常
中断 。
示例中“0”表明工具执行成功。
recognizedPattern
需要优化的代码段数量。
示例中“3”表明有3处代码需要优化。
根据JSON报告进行代码改写。
- 查看advisor_items,其中包含了所有识别到的优化建议。
- 对于每个优化建议,查看begin_line和end_line字段,确定需要替换的代码范围。
- 将sample_code字段中的向量化代码复制并替换源文件对应位置的代码(第begin_line行至第end_line行)。
- 检查headerLocBegin和headerLocEnd字段:
- 如果值为-1,表示头文件已存在,无需添加。
- 如果为正整数,需要在指定位置添加headerFile中的头文件声明。
- 保存修改后的文件,即可完成自动化改写。