全项目扫描模式使用场景
用户可以通过在命令./tiancheng file之后,添加“-j”参数的方式,实现对全项目文件的并行化扫描和分析。
前提条件
以天秤源码优化工具安装路径“/home/tiancheng-x.x.x-Linux-Kunpeng”为例。
全项目扫描分析
./tiancheng file -r /path/to/code_project -o /home/demo -v -j 4

扫描“/path/to”下code_project项目中的所有源码文件,在“/home/demo”下生成每个源码文件对应的向量化检查报告和JSON报告文件。同时指定待分析项目的根目录“/path/to/code_project”,避免头文件缺失。
返回信息如下:
Compile database file does not exist or is unreachable.
Found 372 C/C++ file(s) under '/path/to/code_project.
Analyzing with 4 parallel worker(s). Per-file outputs -> '/home/demo/Vectorization_Optimization_Result_20260813_194910_606_2800'
[scan *] [##############################] 372/372 (100%) | done
Scanned 372 file(s) under '/path/to/code_project with 4 worker(s).
Per-file reports saved under: /home/demo/Vectorization_Optimization_Result_20260813_194910_606_2800 (mirroring the source tree, one sub-directory per file)
扫描任务已完成,分析结果已保存到指定的输出目录中。
输出的目录结构完全复制源码目录结构。对于项目中的每一个源码文件,结果目录中都有一个对应的子文件夹,里面包含该文件对应的详细分析报告。输出目录结构如下所示。
./output_results/
├── demo_imi_flat.cpp
│   ├── scan.log // 源码文件的扫描日志信息。
│   ├── Vectorization_Optimization_Result_20260813_194919_212_5895.json // 源码文件的JSON报告文件。
│   ├── Vectorization_Source_20260813_194919_212_5895.html // 源码文件的HTML向量化检查报告文件。
│   └── Vectorization_Source_20260813_194919_212_5895.json
├── demo_sift1M.cpp
│   ├── scan.log
│   ├── Vectorization_Optimization_Result_20260813_194920_265_1213.json
│   ├── Vectorization_Source_20260813_194920_265_1213.html
│   └── Vectorization_Source_20260813_194920_265_1213.json
└── demo_weighted_kmeans.cpp
    ├── scan.log
    ├── Vectorization_Optimization_Result_20260813_194920_566_4882.json
    ├── Vectorization_Source_20260813_194920_566_4882.html
    └── Vectorization_Source_20260813_194920_566_4882.json
输出目录中包含两类分析报告,请根据实际需求选择查看:
- JSON报告文件:仅包含已成功优化的可向量化代码片段,适用于快速提取优化结果场景。
- HTML报告文件:提供全景视图,详细展示“可向量化”、“潜在向量化”及“不可向量化”三类代码,适用于深入分析优化潜力场景。
查看向量化检查报告
进入输出目录对应源码文件的子文件夹,查看具体信息。此处以查看demo_sift1M.cpp源文件的向量化检查报告文件为例。
- 查看HTML向量化检查报告文件。
报告内容包括循环向量化检查报告、函数向量化检查报告和任务信息。
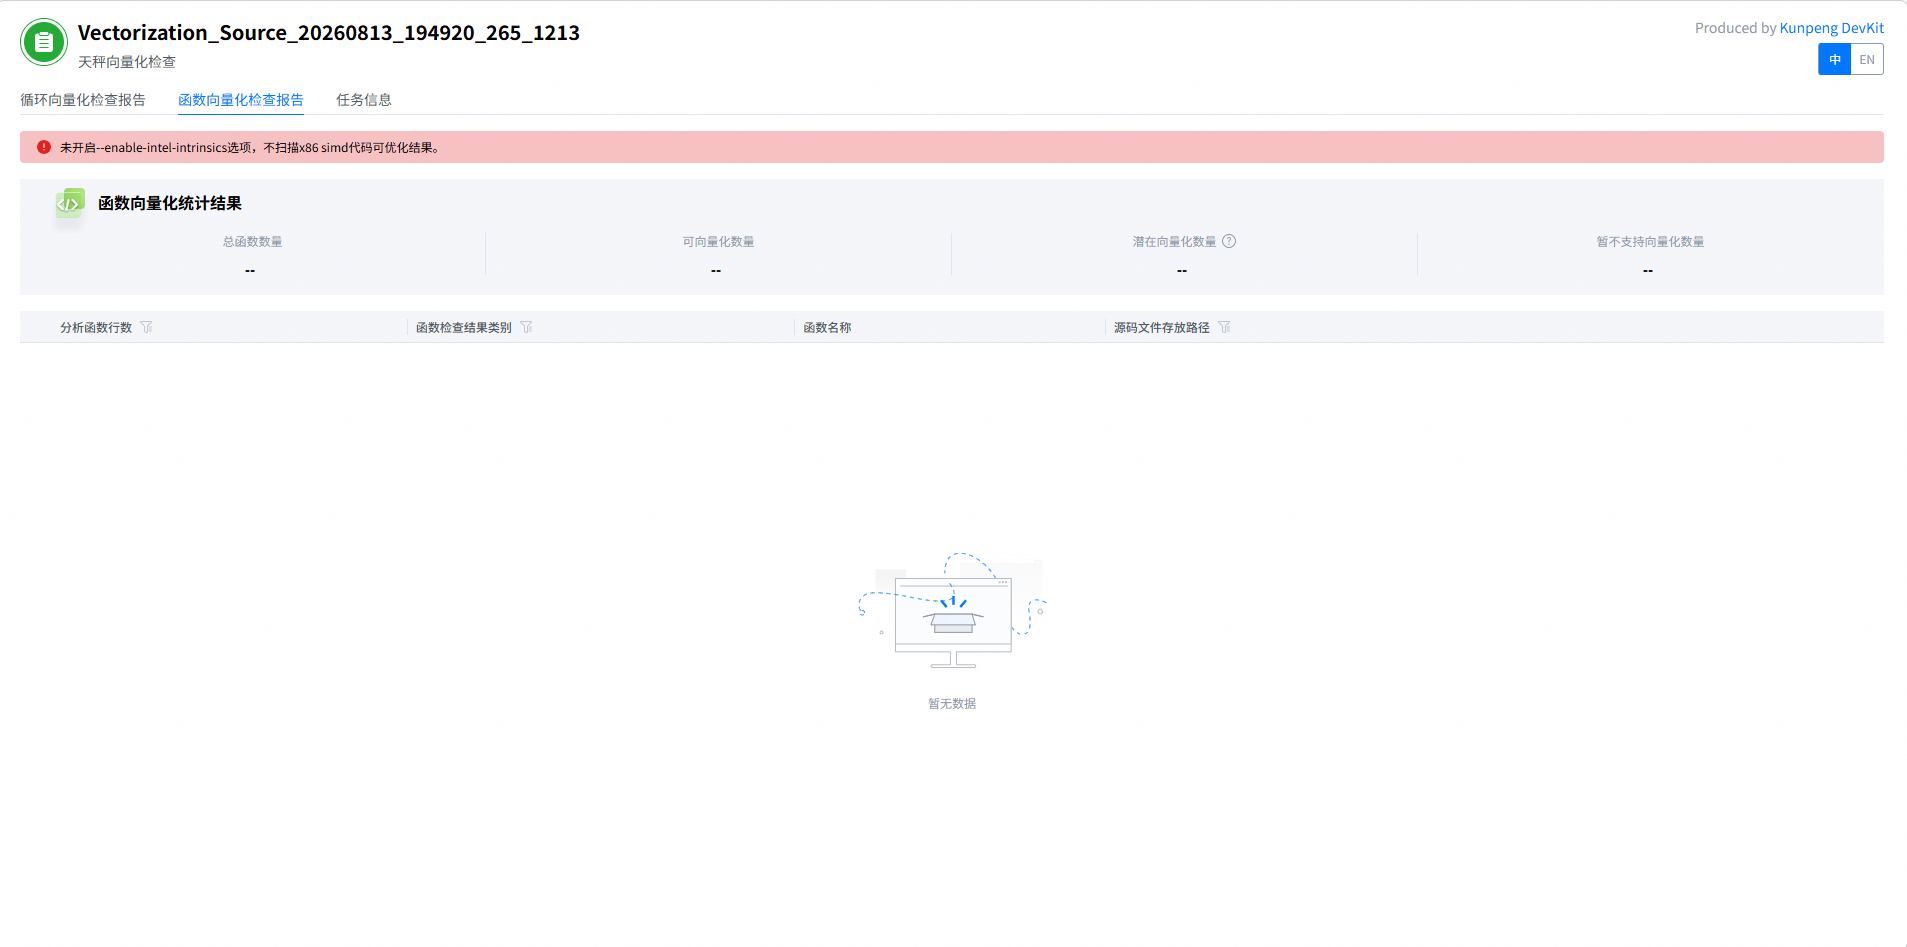
当启用x86 Intel intrinsics分析功能时报告中才有函数向量化检查报告,不启用时报告中的函数向量化检查报告为空。
单击“循环向量化检查报告”查看循环检查结果,具体内容如下图所示,报告结果参数说明请参见表1。
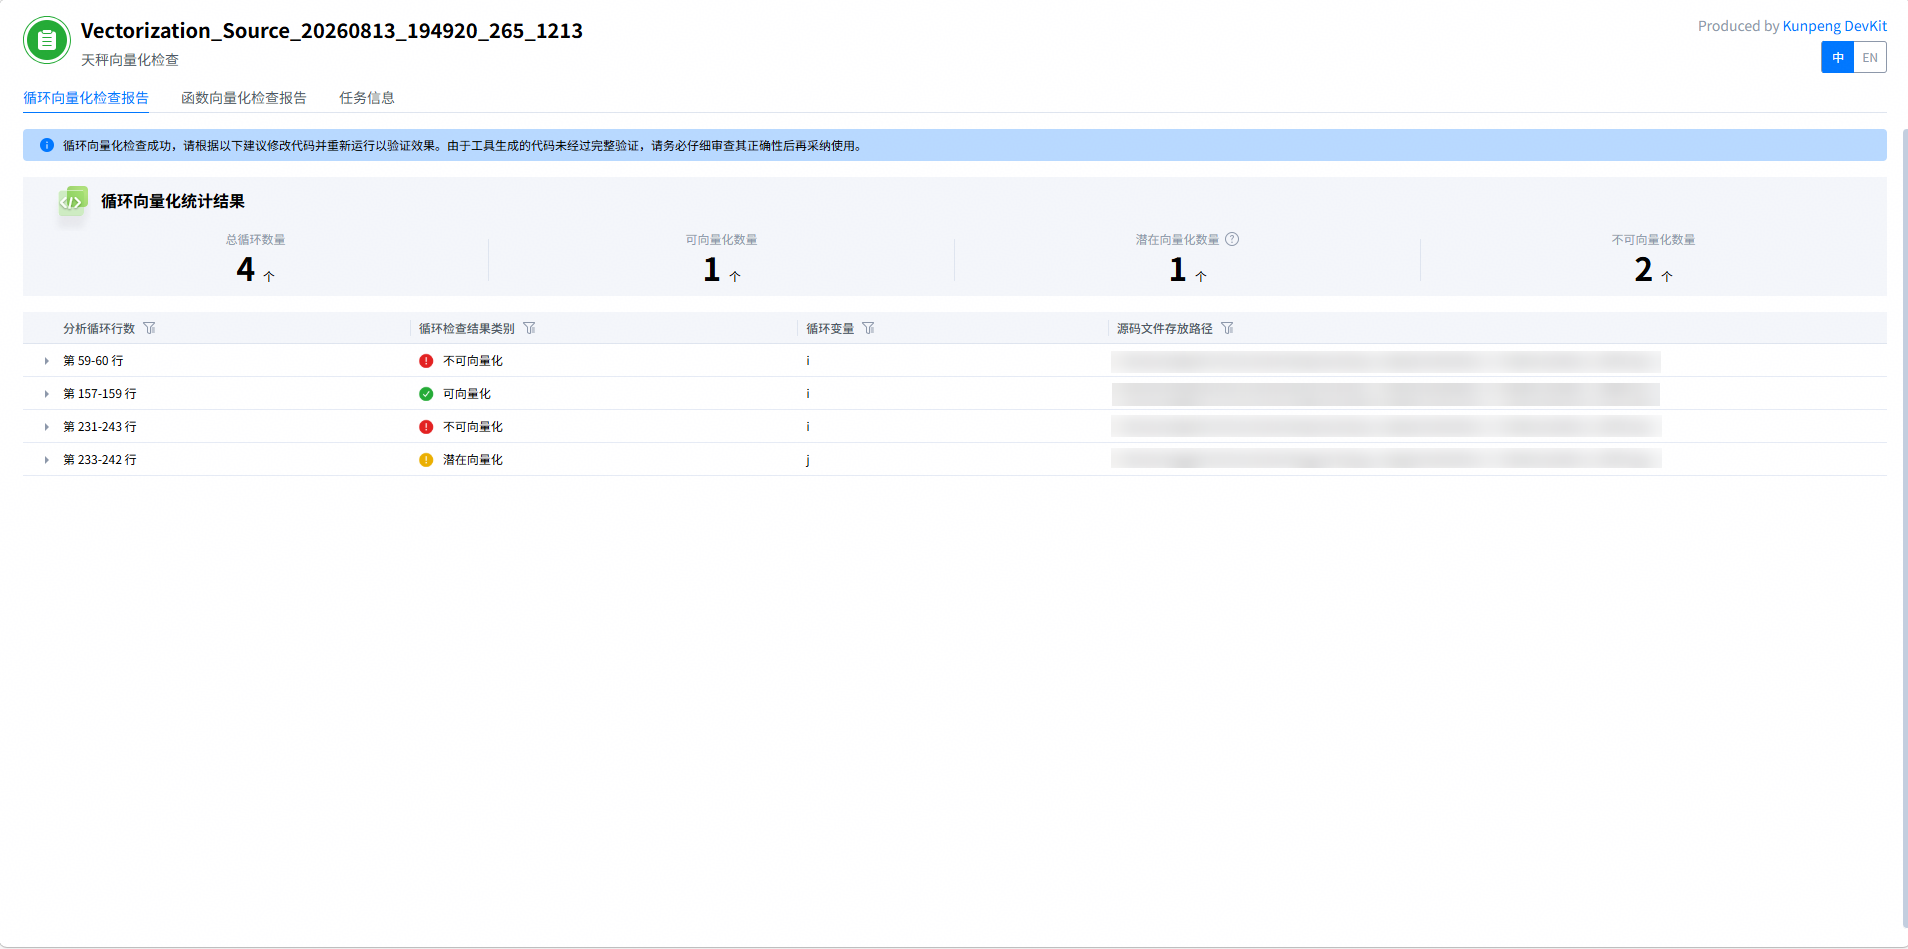
表1 循环向量化检查报告结果参数说明 参数
说明
循环向量化统计结果
总循环数量
源码文件中扫描出的循环总数。
可向量化数量
源码文件中扫描出的可以进行向量化的循环数量。
潜在向量化数量
需要进行特殊处理(如函数内联)才有可能向量化的循环数量。
不可向量化数量
源码文件中扫描出的不可向量化的循环数量。
分析循环行数
被识别为待优化循环的源码在源码文件中的具体行号位置。
循环检查结果类别
天秤源码优化工具检查出的循环类别,包括可向量化、潜在向量化和不可向量化三种类别。
循环变量
在循环中进行循环的变量。
源码文件存放路径
循环所在源码文件的存放路径。
在循环检查结果类别中可以筛选出不同类别的循环,默认全选,单击筛选出的任一行可以展开具体的循环分析过程。
单击“分析循环行数”查看循环分析过程,包括可向量化、潜在向量化、不可向量化三种循环分析过程。循环分析过程参数说明请参见表2。
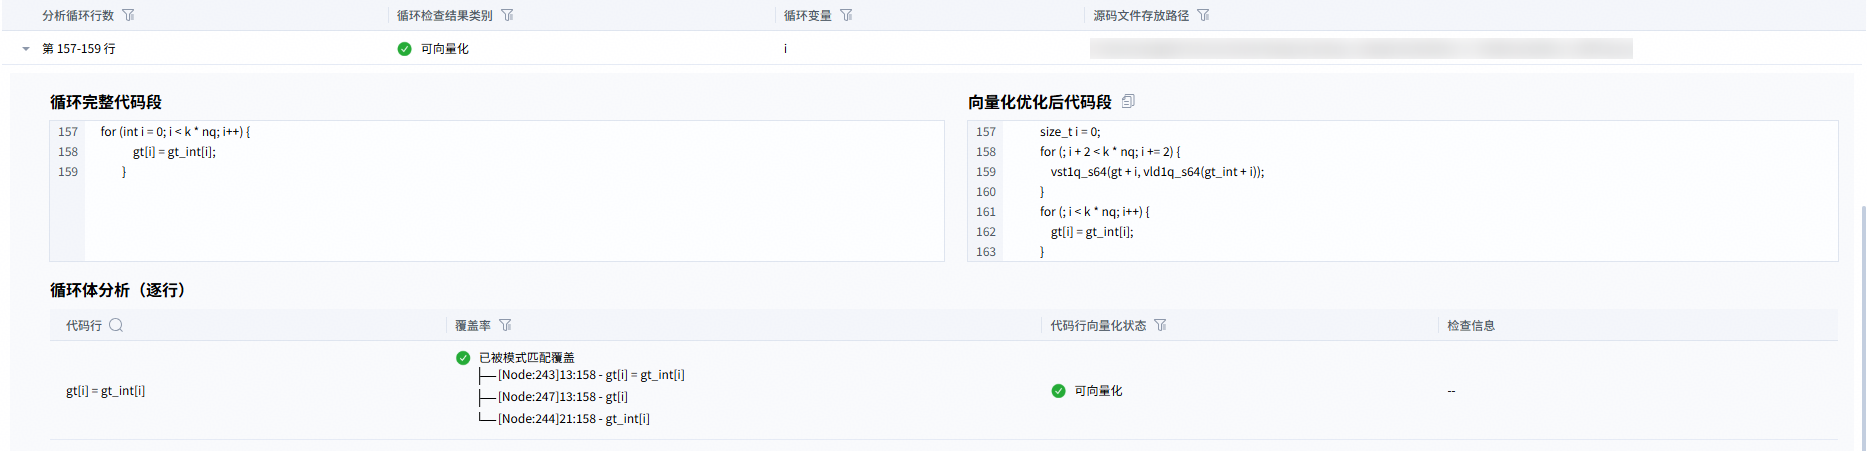
- 可向量化循环分析过程如下图所示。如示例中所示,将向量化优化后的代码段复制并替换源文件对应位置(第157行 ~ 第159行)的代码,保存修改后的文件即可完成改写。
天秤源码优化工具对支持改写的模块,直接提供优化后的代码段;对暂未匹配的模块,将在循环体逐行分析中输出向量化检查信息,可根据向量化检查结果进行优化。
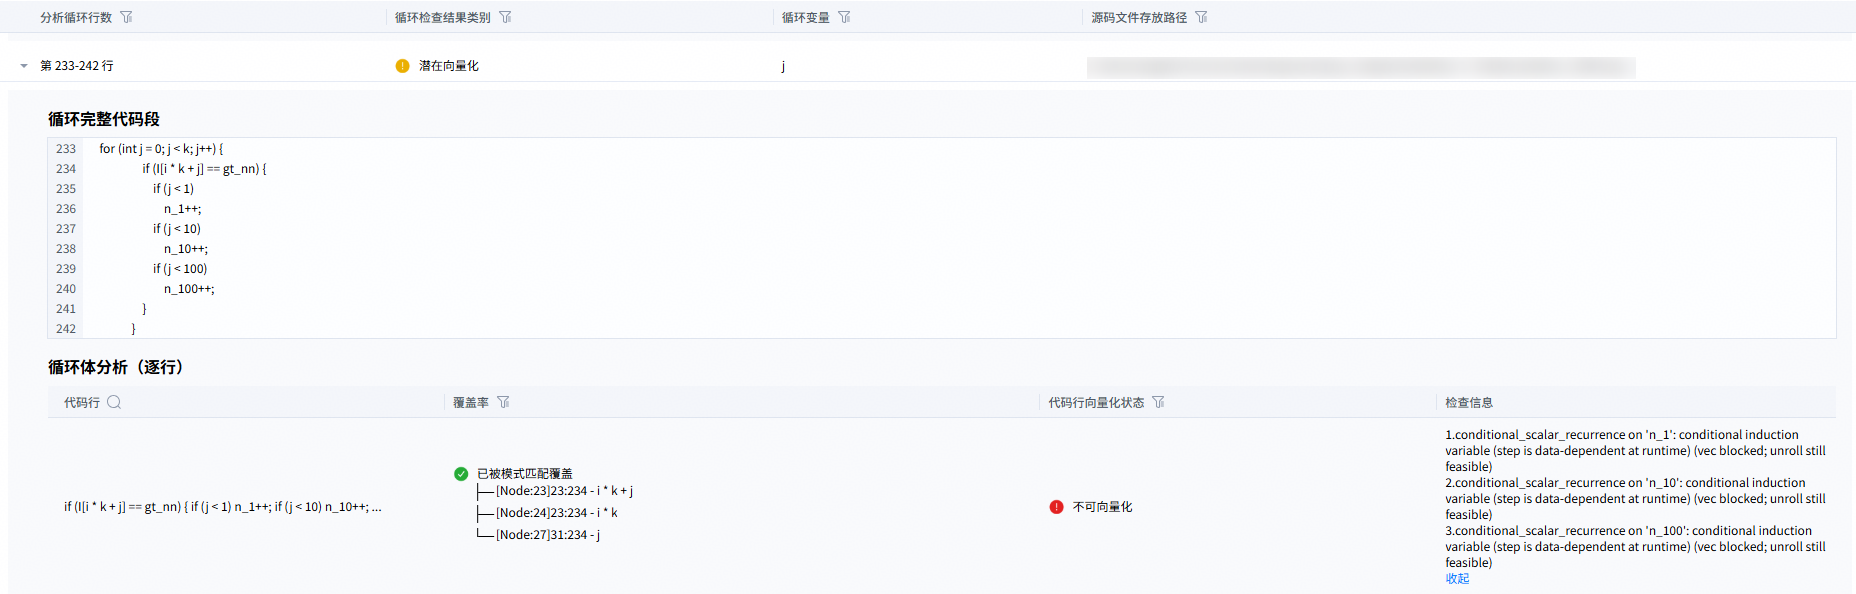
- 潜在向量化循环分析过程如下图所示,根据检查信息可查看源文件对应位置(第233行 ~ 第242行)代码的潜在向量化原因。
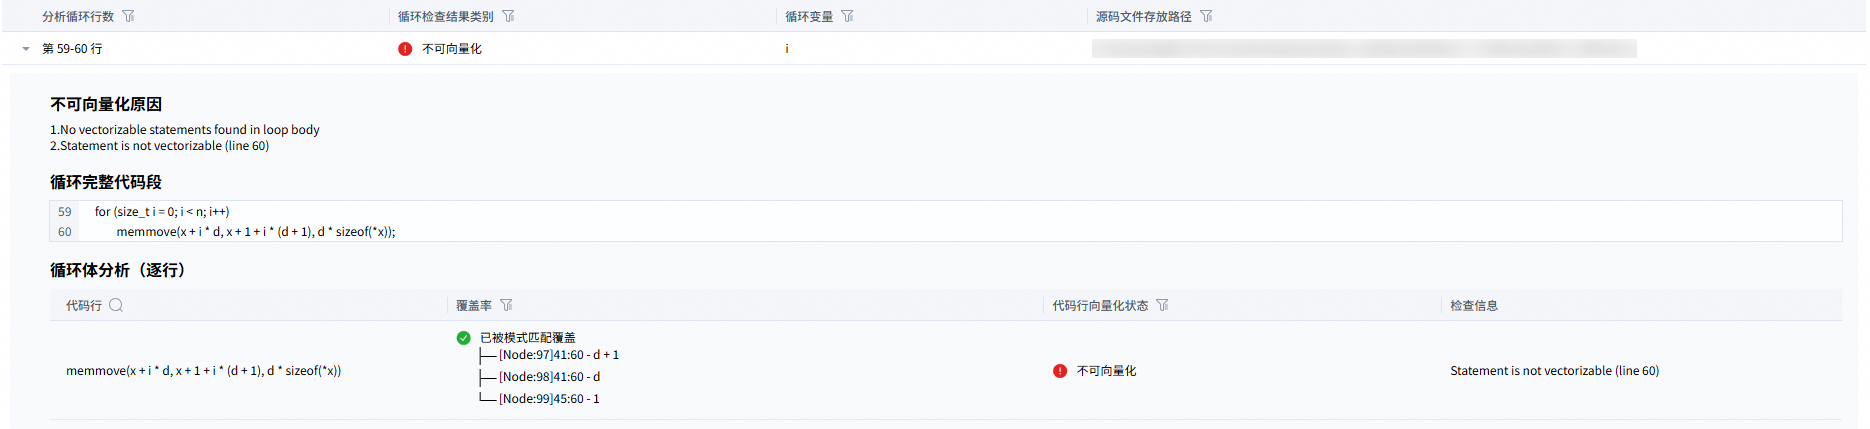
- 不可向量化循环分析过程如下图所示,根据检查信息可查看源文件对应位置(第59行 ~ 第60行)代码的不可向量化原因。
表2 循环分析过程参数说明 循环分析过程
参数
说明
可向量化分析
循环完整代码段
循环在源码文件中的代码段。
向量优化后代码段
天秤源码优化工具对循环进行向量化优化后的代码段。
潜在向量化分析
循环完整代码段
循环在源码文件中的代码段。
不可向量化分析
不可向量化原因
天秤源码优化工具将循环判断为不可向量化的原因。
循环完整代码段
循环在源码文件中的代码段。
公有参数
循环体分析(逐行)
天秤源码优化工具对循环进行检查分析的过程。
代码行
循环中循环体的代码行。
覆盖率
是否被天秤可向量化模式匹配覆盖。
代码行向量化状态
循环体单个代码行的向量化状态,包括可向量化、潜在向量化、不可向量化三种类别。
检查信息
天秤源码优化工具对代码行的检查分析结果。
说明:如果代码行向量化状态为可向量化,则不显示检查信息;如果代码行向量化状态为潜在向量化和不可向量化,则显示对应的原因或建议。
未开启x86 Intel intrinsics分析功能,函数向量化检查报告内容为空。具体内容如下图所示。
单击“任务信息”可查看当前检查报告的生成信息,具体内容如下图所示,任务信息参数说明请参见表3。
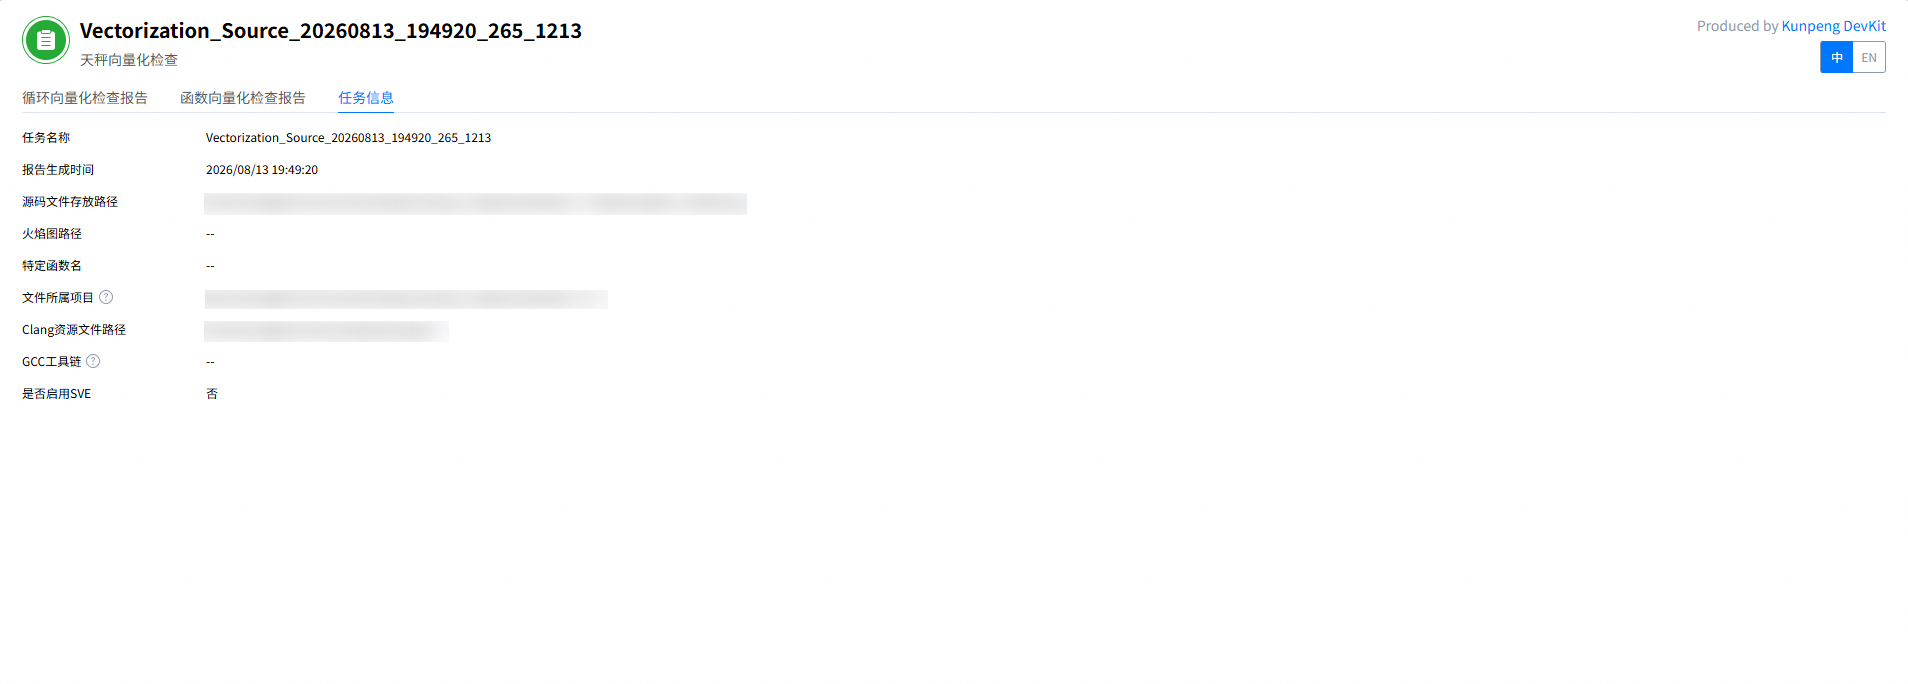
在“任务信息”中可快速查看报告名称、报告生成时间、源码存放路径等相关信息。
表3 任务信息参数说明 参数
说明
任务名称
天秤源码优化工具自动创建的检查任务名。
报告生成时间
天秤源码优化工具生成报告的时间。
源码文件存放路径
扫描的源码所在文件的路径。
火焰图路径
扫描的火焰图SVG文件的路径。
特定函数名
扫描的函数名。
文件所属项目
待分析源码文件所属项目的根目录。
Clang资源文件路径
Clang内置头文件(如stddef.h)所在的目录。
GCC工具链
GCC编译器安装的目录,作为代码分析时的工具链路径。
是否启用SVE
是否转换为SVE指令集。
HTML报告侧重诊断分析,需根据提示人工调整代码结构,调整后重新验证效果。
- 可向量化循环分析过程如下图所示。如示例中所示,将向量化优化后的代码段复制并替换源文件对应位置(第157行 ~ 第159行)的代码,保存修改后的文件即可完成改写。
- 查看JSON报告文件。
vim /home/demo/Vectorization_Optimization_Result_20260813_194910_606_2800/demo_sift1M.cpp/Vectorization_Optimization_Result_20260813_194920_265_1213.json
JSON文件详情如下:
{
  "advisor_items": [
    {
      "opt_file": {
        "begin_line": 157,
        "description": "",
        "end_line": 159,
        "fileName": "/home/demo/demo_sift1M.cpp",
        "headerFile": {
          "name": "#include <arm_neon.h>",
          "operation": "add"
        },
        "headerLocBegin": 8,
        "headerLocEnd": 8,
        "sample_code": "        size_t i = 0;\n        for (; i + 2 < k * nq; i += 2) {\n            vst1q_s64(gt + i, vld1q_s64(gt_int + i));\n        }\n        for (; i < k * nq; i++) {\n            gt[i] = gt_int[i];\n        }"
      }
    }
  ],
  "code": 0,
  "recognizedPattern": 1
}
表4 字段说明 字段
字段说明
advisor_items
代码优化点建议数组,里面的每一项都是一个代码优化点建议。
opt_file
单个优化建议的详细信息。
begin_line
需要优化代码的起始行号。
示例中“157”为优化代码的起始行号。
description
优化建议的详细描述。
end_line
需要优化代码的结束行号。
示例中“159”为优化代码的结束行号。
fileName
当前分析的源文件所在路径。
示例中“/home/demo/demo_sift1M.cpp”为分析的源文件所在路径。
headerFile
向量化过程中涉及的头文件处理信息。
示例中"name": "#include <arm_neon.h>"表明此段代码需要新增或替换的目标头文件,用于使用NEON指令集,"operation": "add"表明该指定头文件的处理方式。
“operation”包含的两种处理方式:
- “add”:用于标量代码向量化时新增目标头文件。
- “replace”:用于x86向ARM向量化迁移时将原有x86头文件替换为对应的ARM头文件。
headerLocBegin
头文件插入的起始行号。
- 若为-1,表示头文件在原始代码中已经包含,无需手动添加。
- 若为正整数,表示头文件插入的起始行号。
示例中“8”为头文件插入的起始行号。
headerLocEnd
头文件插入的结束行号。
- 若为-1,表示头文件在原始代码中已经包含,无需手动添加。
- 若为正整数,表示头文件插入的结束行号。
示例中“8”为头文件插入的结束行号。
sample_code
推荐的向量化实现代码样例,可直接用于替换源文件的原始代码。
示例中以下代码为优化后的代码样例。
size_t i = 0;\n for (; i + 2 < k * nq; i += 2) {\n vst1q_s64(gt + i, vld1q_s64(gt_int + i));\n }\n for (; i < k * nq; i++) {\n gt[i] = gt_int[i];\ncode
工具执行状态码。
- 0表示工具执行成功。
- 非零值表示异常
中断 。
示例中“0”表明工具执行成功。
recognizedPattern
需要优化的代码段数量。
示例中“1”表明有1处代码需要优化。
根据JSON报告进行代码改写。
- 查看advisor_items,其中包含了所有识别到的优化建议。
- 对于每个优化建议,查看begin_line和end_line字段,确定需要替换的代码范围。
- 将sample_code字段中的向量化代码复制并替换源文件对应位置的代码(第begin_line行至第end_line行)。
- 检查headerLocBegin和headerLocEnd字段:
- 如果值为-1,表示头文件已存在,无需添加。
- 如果为正整数,需要在指定位置添加headerFile中的头文件声明。
- 保存修改后的文件,即可完成自动化改写。